


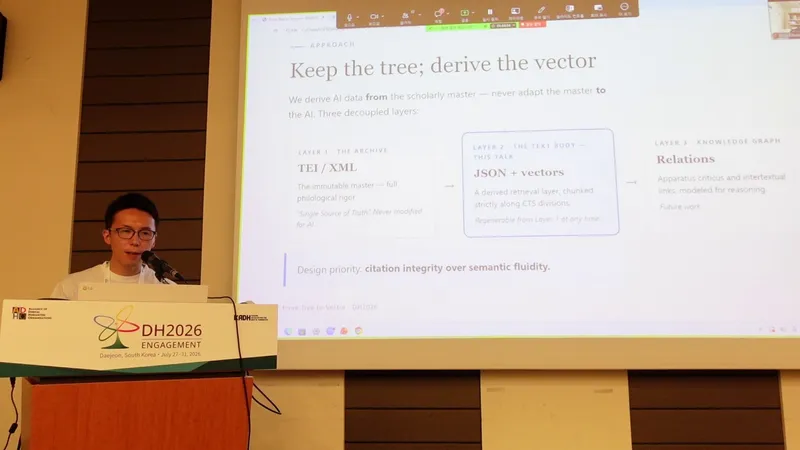
7月31日、金曜日の朝。韓国・大田(テジョン)のコンベンションセンターで、私は日本語で発表を始めました。国際学会で日本語を使って発表するのは、私にとって初めての経験です。
デジタル人文学の国際会議DH2026では、会場にAIによる同時翻訳の仕組みが導入されていました。111あるセッションのうち89のセッションで発表音声が翻訳され、聴衆はそれぞれの端末から別の言語で内容を追うことができます。AIを研究対象のひとつとする学会そのものが、AIを使って多言語化されている。そのこと自体が、今回の大会を特徴づける出来事のひとつだったように思います。
私はこれまで9年ほどイギリスで研究生活を送り、国際学会では当然のように英語を使ってきました。その経験があるだけに、今回、日本語で発表し、日本語で質疑に答えたことは、国際的な研究交流と言語との関係を改めて考える機会になりました。
「Engagement」の学会で
DH2026は、Alliance of Digital Humanities Organizations(ADHO)の年次大会です。今年は韓国デジタル人文学会(KADH)がホストを務め、7月27日から31日まで開催されました。大会テーマは「Engagement」。421件の口頭発表と94件のポスターが、111のセッションに分かれて行われる大規模な会議です。
Humanitextプロジェクトからは、今回は3件の研究成果を発表しました。
水曜日には田中一孝さんが、Humanitext Aozoraに寄せられた実際の質問ログを分析し、LLMを組み込んだ文学アーカイブにおいて、利用者が文学作品とどのように関わるのかを報告しました。検索して資料を見つける従来型のデジタルアーカイブと、自然言語で問いを投げかけることのできるアーカイブとでは、利用の仕方そのものが少し変わってきます。その変化を、実際の利用データから検討したものです。
私が金曜日に発表したのは、「From Tree to Vector」というタイトルの研究です。TEI/XMLで記述された人文学資料の階層構造と、RAG(検索拡張生成)が扱うベクトル検索とのあいだを、どのように接続するかという問題を扱いました。
話の中心はかなり実装寄りです。
たとえばプラトンであれば「43a」のようなステファヌス頁、アリストテレスであればベッカー頁、ホメロスであれば「第1歌1行」といったように、西洋古典には長い研究史のなかで定着した引用体系があります。研究者はそれによって、版や翻訳が違っていても、おおむね同じ箇所を指し示すことができます。
ところが、RAGのためにテキストを一定の語数やトークン数で機械的に分割すると、こうした単位が簡単に壊れてしまいます。そこでHumanitextでは、既存の引用単位をできる限り保持しながら、短すぎるセクションはまとめ、長すぎるセクションは分割し、それぞれのチャンクに引用規範に基づく識別子を持たせています。
個々の処理だけを見れば、特別に派手なものではありません。しかし、検索された文章が原典のどこに対応するのかを正確に示せるかどうかは、研究用途ではかなり重要です。検索精度だけでなく、回答をあとから検証できるかどうかにも直接関わります。
RAGでは「どれだけ適切な文章を検索できるか」が注目されがちですが、人文学資料を扱う場合には、「検索された文章を既存の学術的な参照体系へ戻せるか」という問題も同じくらい重要だと考えています。
英語の質問に、日本語で答える
発表後の質疑では、質問は英語で行われました。私はそれに日本語で答えました。
英語で質問されている内容は分かりますし、英語で答えることもできます。それでも、質疑応答となると事情は少し違います。あらかじめ準備した発表原稿とは違い、その場で問いの意図を考え、自分の立場を整理し、必要であれば留保をつけながら答えなければなりません。
そのとき母語を使えることの差は、思っていた以上に大きいものでした。
とくに印象的だったのは、単に「英語を話さなくてよいから楽だった」ということではありません。日本語で答えることで、普段なら英語に直す過程で少し単純化してしまうような区別やニュアンスまで、そのまま盛り込むことができました。
今回の翻訳については、少なくとも私が経験した範囲では、かなり実用的な水準に達していたように思います。場合によっては、私自身がその場で英語を組み立てて答えるよりも、日本語で内容を十分に組み立ててからAIに翻訳させた方が、意図したことが正確に伝わっていた可能性すらあります。
もちろん、専門用語や固有名詞を含む翻訳については慎重に見なければなりませんし、どの分野でも同じように機能するとは限りません。それでも、国際学会に参加するためには発表者が英語を使わなければならない、というこれまでほとんど自明だった条件が、技術的には少しずつ変更可能になっていることは確かです。
英語が国際的な研究交流の共通語であること自体は、すぐには変わらないでしょう。しかし、「共通語を使うこと」と「すべての人が同じ言語で話すこと」は、必ずしも同じではありません。今回の経験は、その二つを分けて考えることができる段階に入りつつあることを感じさせるものでした。
学生たちとのポスター
もうひとつの発表は、「Visualizing Classical Narratives via RAG-Enhanced AI and Iterative Video Synthesis」というポスターです。
これは、RAGによって典拠を確認しながら、生成AIを用いて古典の物語を映像化していく方法を検討した研究で、映像作品『ANIMA ANTIQUA』の制作を通じて進めてきたものです。共著者には、名古屋大学の大学院生である齋藤千枝歌さんと鈴木祐希さんが参加しています。
この研究で問題にしたのは、単に「AIで古典を映像化できるか」ということではありません。
生成された映像には、さまざまな種類の誤りが入り込みます。原典にない人物や物が現れることもあれば、時代的に不適切な衣服や建築物が生成されることもあります。一方で、何を「誤り」と見なすか自体が簡単ではない場合もあります。テキストに明示されていない部分については、ある程度の解釈が避けられないからです。
そこで、どのような問題であれば機械的に検出できるのか、どこから専門家による判断が必要になるのかを整理しながら、生成と評価を反復する仕組みを考えました。
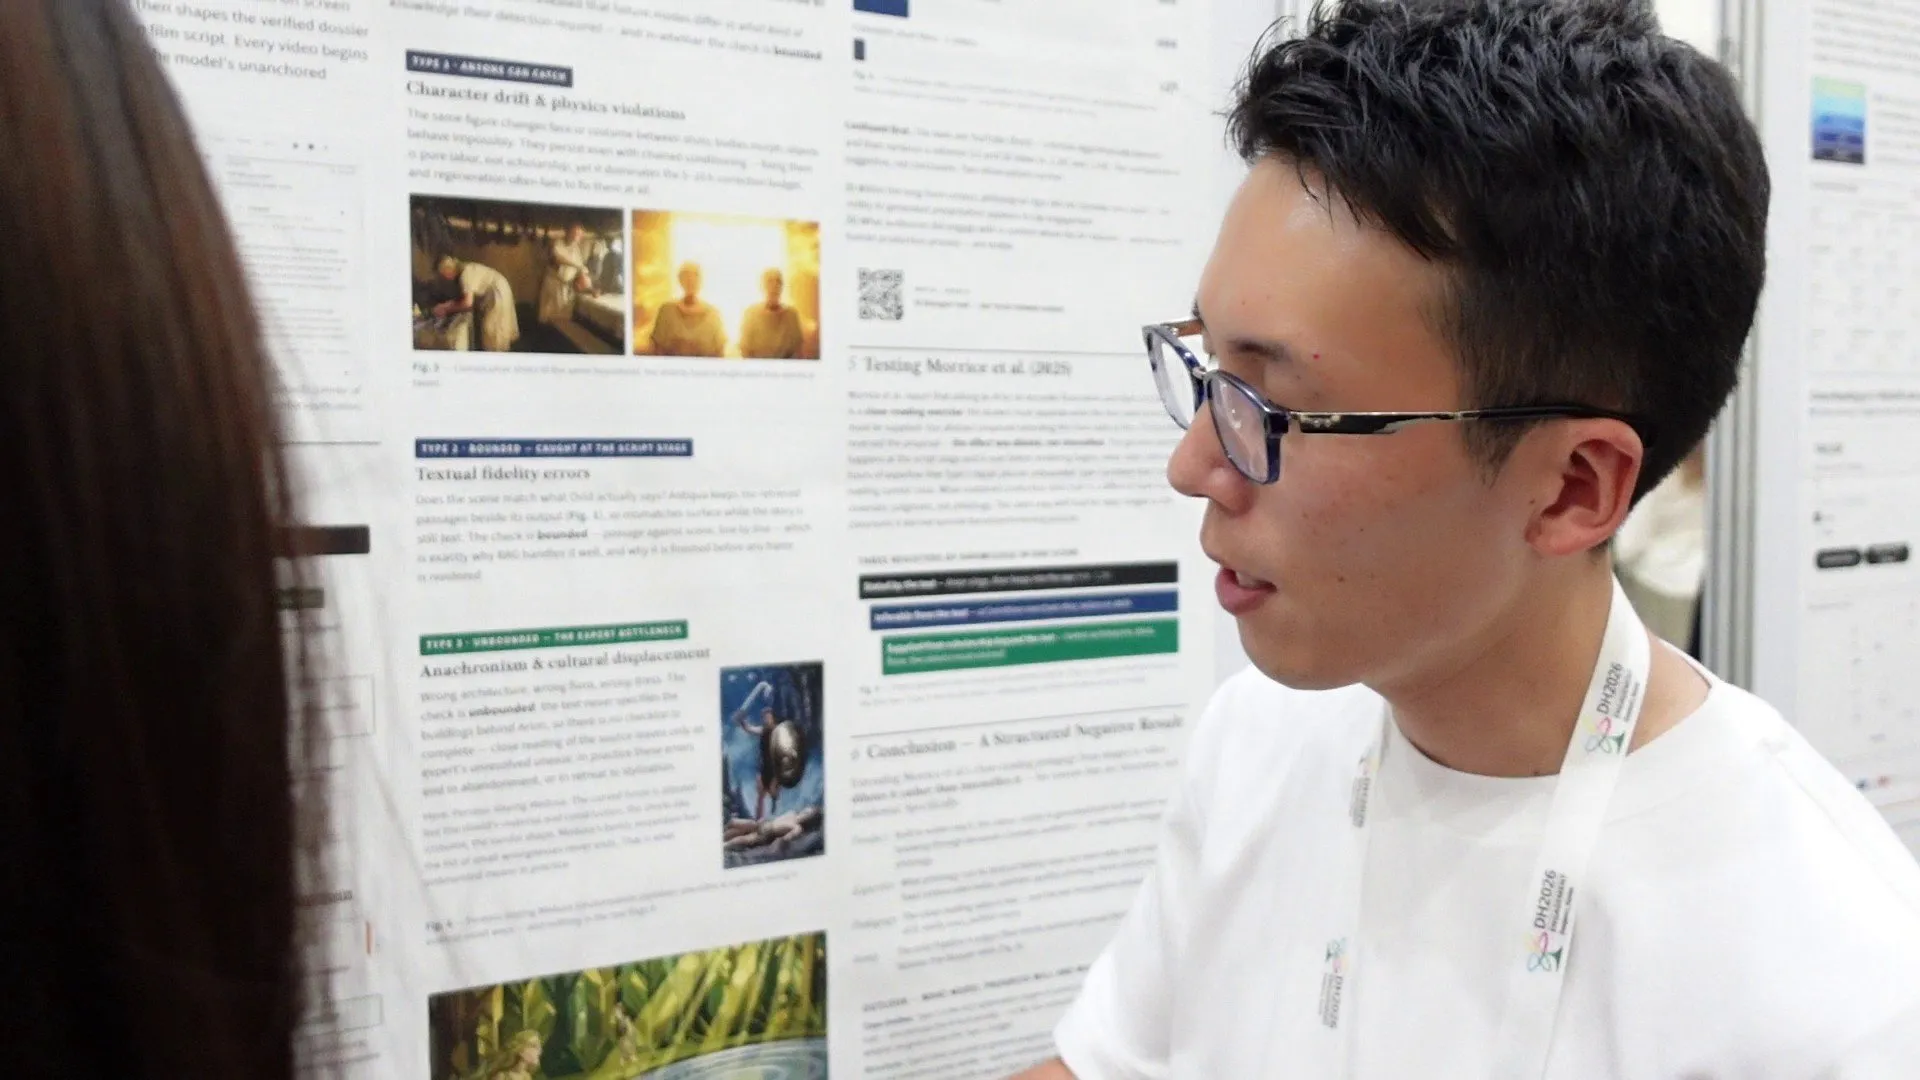
ポスター発表では、この点について参加者とかなり具体的な議論ができました。口頭発表では限られた時間のなかで研究全体を説明する必要がありますが、ポスターでは、ひとつの論点について立ち止まって話すことができます。生成AIを人文学研究に使う場合、何を自動化し、何を人間の判断として残すのかという問題に関心を持つ研究者は多く、この研究についてもいくつか有益な意見をもらうことができました。
学生と一緒に進めてきた研究を、こうした場で議論できたことも、今回の参加の大きな収穫のひとつでした。
大田で考えたこと
アジアでの開催ということもあり、会場では韓国・日本・中国の資料を扱う研究が目立ちました。漢文仏典、『日本書紀』のTEIマークアップ、唐詩の計算分析など、対象は多岐にわたります。その一方で、西洋古典を正面から扱った発表は、この規模の大会としては意外なほど少ないように感じました。
もちろん、資料が違っていても学ぶことは多くあります。テキストをどのような単位で扱うか。複雑な構造をどう記述するか。既存の参照体系をどう機械に渡すか。検索や生成の結果をどう検証可能にするか。今回の大会でも、専門外のセッションから多くの示唆を得ました。
その一方で、会場を回りながら考えていたのは、研究として新しいことを示す仕事と、実際に使われる環境を育てていく仕事との違いでした。
DHも研究である以上、「この研究によって何が新しく分かるのか、あるいは何が新しくできるようになるのか」を示す必要があります。新しい分析手法を提案することもあれば、既存の技術を別の資料や研究課題に適用することもある。研究成果としてまとめる以上、何らかの新規性は必要です。
Humanitext Readerは、それとは少し性格の違う仕事です。
技術的な骨格だけを見れば、生成AIを使って古代ギリシア語やラテン語を翻訳し、原文と並べて公開しているものです。新しい翻訳モデルを開発しているわけでも、独自のアルゴリズムを発明しているわけでもありません。
しかし、実際に研究者や学習者が使えるものにしようとすると、そこにはかなりの調整が必要になります。元データを整え、翻訳の品質を安定させ、長い作品を適切な単位で処理し、原文と訳文の対応を保ち、固有名詞や専門語の揺れを抑える。公開後には、誤りの修正や資料の追加、表示の改善も続きます。
こうした問題のなかには、切り出して検証すれば研究テーマになるものもあります。ただ、実際にサービスを運用する段階では、それらの多くは細かな調整や保守の積み重ねとして現れます。一つひとつを研究成果としてまとめるわけではありませんが、どれかを疎かにすれば、使い勝手は確実に落ちます。
さらに、作ったものは、存在するだけでは使われません。実際に使ってほしい人たちに知ってもらい、授業や研究のなかで試してもらい、その反応を見ながら改善していく必要があります。
難しいのは、こうした仕事と研究との境界が必ずしも明確ではないことです。
新しい問いや方法を提示する研究と、そこで得られた成果を継続的に使える環境へ育てていく仕事は、重なる部分を持ちながらも同じではありません。前者は論文や学会発表として形にしやすい。一方、後者には相当な時間がかかるにもかかわらず、その価値は学術的な評価の仕組みには必ずしも乗りやすくありません。
それでも、ある分野にデジタル技術を本当に定着させようとすれば、後者の仕事を避けて通ることはできないように思います。
Humanitextを今後どう育てていくのかを考えるとき、この二つのバランスはますます重要になっています。新しい研究を続けることと、すでに作ったものを研究や学習の基盤として育てていくこと。その二つに、限られた時間をどう配分するのか。
今回、大田で多くの研究発表を見ながら、むしろそのことを考えていました。
まだ、明確な答えはありません。
関連する記事
オックスフォード訪問記:西洋古典学とデジタル技術の接点
オックスフォード大学マートン・カレッジにジョナサン・プラグ教授を訪ね、碑文コーパスI.SicilyとHumanitextの接点、西洋古典学におけるデジタル技術とAIの受容について話しました。キーブル・カレッジと新しい人文学センターの見学も含む訪問記です。
忘れさせる神、忘れない男:『オデュッセイア』の結末
映画『オデュッセイア』の結末が引っかかった方へ。原典は求婚者を討ってからも続き、最後は神が人々に忘れさせて平和を用意します。映画はその終わり方をどう変えたのか。忘却と記憶をめぐる二つの結末を、原典の行から読み比べます(映画の結末に触れます)。
『オデュッセイア』のアテナ――原典と映画はどう違うのか?
映画のアテナはなぜ主人公を救わず、責めもしないのか。原典で主人公と知恵を分かち合い、帰還の要所で介入する女神の姿と突き合わせると、映画の演出の狙いが見えてきます。
映画『オデュッセイア』を観てきました
ノーラン監督の映画『オデュッセイア』を、先行上映でHumanitextのメンバーと観てきました。昼食の席で話題になった巨人の姿、セイレーンの歌、帰郷のあとの旅について、原典ではどう書かれているかを、ネタバレなしで記します。